RK3588 设备 7×24 长期运行的稳定性设计要点
RK3588 设备 7×24 稳定运行是分层工程:硬件层保电源与散热余量,系统层靠看门狗与只读根文件系统,应用层做进程自恢复,运维层留远程日志与回滚通道。判定靠 72 与 168 小时老化测试指标。
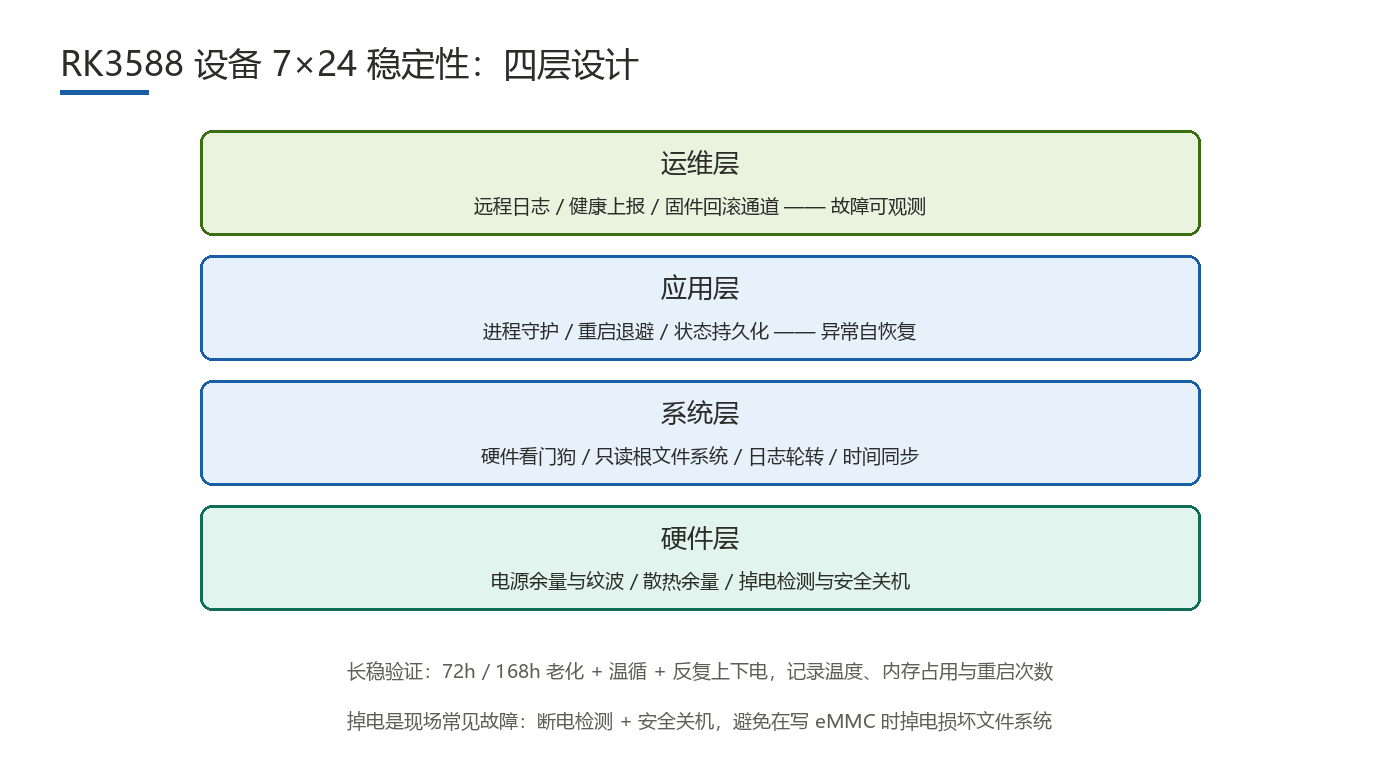
7×24 长期运行的稳定性问题出在哪几层?
短期能跑不等于长期稳定,只有长时间运行才会暴露的失效往往来自四层:
- 硬件层:电源余量不足在高温下崩溃、散热余量不足导致降频、连接器与线缆接触不良、风扇等运动部件的寿命。
- 系统层:内存与句柄缓慢泄漏、日志写满存储、根文件系统被写坏、时间同步异常。
- 应用层:进程异常退出后无人拉起、重启风暴、关键状态未持久化导致重启后状态丢失。
- 运维层:无远程日志与健康上报,故障后无法定位,也没有固件回滚通道。
分层的意义在于定位:先判断故障属于哪一层,再逐层细分,能缩短排查时间。经验上,长期运行问题中电源与散热占相当比例,但排查时容易被误判为软件崩溃。
硬件层怎么做稳定性设计?
- 电源余量:按峰值负载留余量(经验上不低于 30%),关注纹波与瞬态响应,电压跌落是掉电与重启的常见诱因。
- 散热余量:按设备内部实测的高温环境(如 50~60°C 环温)评估结温,而不是在常温台面测;散热余量不足会在高温下触发降频。
- 连接器与线缆:振动与温度循环会加速接触不良,关键连接应做固定与防松,线缆走向避免长期应力集中。
- 运动部件寿命:风扇是典型易损件,选型关注轴承类型与标称寿命,并设计转速监控与失速告警,避免风扇停转后才暴露问题。
硬件余量的具体数值须以实测与器件规格为准,RK3588 各型号的功耗与热设计约束以原厂官方规格书为准。散热设计建议在整机恶劣工况下验证,而非样机裸板测试。
系统层有哪些关键措施?
- 硬件看门狗与进程守护:看门狗提供一层「死机也能复位」的兜底,但喂狗逻辑必须能真实反映系统健康,不能由某个独立线程无脑喂狗。
- 泄漏的长期验证:内存与句柄泄漏在短测中不明显,必须跑长时间测试并记录内存占用、句柄数、线程数曲线,观察是否单调上升。
- 只读根文件系统与日志轮转:根文件系统只读可避免意外写坏导致无法启动;日志与临时数据放到独立可写分区并做轮转与容量上限。
- 时间同步与时间跳变:断电后系统时间会回跳,依赖时间的逻辑(证书校验、日志排序、任务调度)可能出错,应等网络时间同步完成后再执行敏感任务。
- RTC 与纽扣电池:需要离线保持时间的设备配 RTC 与纽扣电池,并把电池寿命纳入维护计划。
只读根文件系统加独立数据分区是长期运行的基本盘:它把「系统被写坏」的故障概率降到很低,同时让固件升级与数据管理的边界更清晰。
应用层怎么设计进程自恢复?
- 进程自恢复:关键进程由守护机制监控,异常退出后自动拉起,并记录退出码与退出时间便于分析。
- 重启风暴抑制:若进程反复崩溃,无限制拉起会造成重启风暴,应加入退避策略(重启间隔递增)与次数上限,超过上限后进入安全模式并上报。
- 异常状态上报:崩溃、看门狗复位、资源超限等异常要上报到运维平台,保留时间戳与上下文,形成可分析的故障记录。
- 关键状态持久化:把业务关键状态定期落盘,重启后可恢复到一致状态;写入要防掉电,避免落盘到一半损坏状态文件。
自恢复设计的原则是「允许失败、快速恢复、留下证据」:不追求进程永不崩溃,而是保证崩溃后系统能自动回到可用状态,并保留现场信息供事后分析。
掉电保护怎么做才靠得住?
掉电是长期运行设备的常见威胁,尤其在写 eMMC 时掉电可能损坏文件系统。做法分三步:
- 断电检测与安全关机:检测到输入电压跌落时,及时触发安全关机流程,完成写入中的操作并同步缓存。
- 超级电容或 UPS 的取舍:超级电容成本低、寿命长但储能有限,只够支撑短暂的安全关机;UPS 储能更多,但体积与成本更高并引入电池寿命管理。按安全关机所需时间选型。
- 避免在写存储时掉电:关键写入设计成原子操作(先写临时文件再改名),并缩短写入窗口,减少掉电落在写入过程的概率。
掉电保护的效果必须实测:在写入过程中反复断电,检查文件系统是否损坏、设备能否自动恢复。具体储能器件与时长须以实测与器件规格为准。
长稳验证怎么测?故障怎么定位?
验证要有明确的时长、工况与判定指标:
| 层级 | 关键措施 | 验证方法 |
|---|---|---|
| 硬件层 | 电源与散热余量、连接器可靠性、风扇寿命 | 高温环境长时间满载运行,监测结温与降频次数 |
| 系统层 | 看门狗、泄漏控制、只读根文件系统、时间同步 | 168 小时连续运行,记录内存与句柄曲线、复位数 |
| 应用层 | 进程自恢复、退避策略、状态持久化 | 主动注入进程崩溃,验证恢复时间与状态一致性 |
| 整机 | 掉电保护与反复上下电 | 反复上下电冲击,检查文件系统与启动成功率 |
常见组合是 72 小时功能老化与 168 小时长稳测试,配合温循、反复上下电冲击与长时间大流量压力。判定通过的指标至少包括:无异常重启或看门狗复位、内存与句柄无单调上升趋势、关键业务全程可用、断电后能自动恢复并保持数据一致。只记录「没死机」是不够的,没有量化曲线的测试无法说明长期趋势。
故障定位建议按「先分层、再细分」:先判断是供电、散热、存储还是软件问题;确认层级后用日志、寄存器状态与实测数据缩小范围,例如用温度与频率曲线区分散热与软件卡顿;把故障条件收敛到可重复的小场景后再验证修复效果。这套顺序能避免「一上来就改代码」,很多看似软件崩溃的问题根因在电源或散热。
常见问题
- Q1:7×24 设备必须做 168 小时老化测试吗?建议至少做一轮 168 小时长稳,配合 72 小时功能老化。短测无法暴露缓慢泄漏与温升累积,测试要记录量化曲线而非只记录是否死机。
- Q2:看门狗能替代进程自恢复吗?不能。看门狗处理整机级死机并复位,进程级异常应由守护机制处理并留日志,两者分层,缺一不可。
- Q3:掉电保护用超级电容还是 UPS?按安全关机所需时间选:支撑时间短、体积受限选超级电容;更长续航或带电池管理能力选 UPS,具体时长以实测为准。
- Q4:长时间运行变慢可能是什么原因?优先排查散热导致的降频,其次是内存或句柄泄漏引起的内存压力。用温度、频率与内存曲线交叉判断比猜测更快。